Optimiser les horaires de séances de curling

Cet article fait partie de notre série d’aperçus de Curling IO v3, où nous explorons certaines fonctions offertes dans la prochaine version.
Curling IO v3 comprend un nouvel écran de planification des séances pour les parties d’événement. L’horaire est une grille de séances et de ressources du club, avec les parties non attribuées dans une file à côté. Vous pouvez déplacer les parties par glisser-déposer, verrouiller certains placements et utiliser Répartir et Optimiser en respectant ces verrous.
Contrairement à un générateur de modèles d’horaires distinct, cet éditeur travaille avec les vraies équipes, étapes, parties, ressources et heures de séance de l’événement. Enregistrer l’horaire met directement l’événement à jour.
Vous pouvez déjà essayer la plupart de l’interface sur CurlingSchedules.com. Elle utilise des équipes génériques et des sauvegardes locales au navigateur plutôt que les parties réelles d’un événement. La grille, le glisser-déposer, les verrous, les horaires du catalogue, l’inspection de l’équité et l’optimisation sont toutefois disponibles dès aujourd’hui.
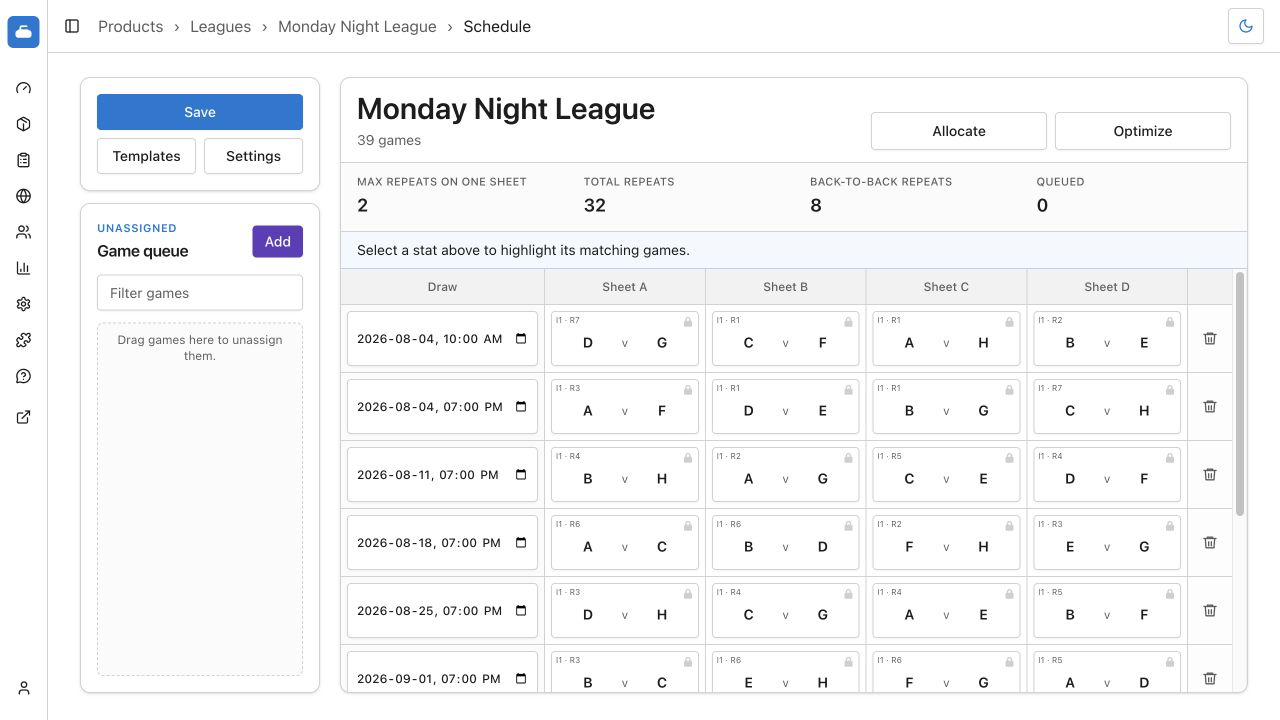
L’éditeur de la version 3 réunit la file de parties, les commandes d’événement, les heures de séance, les ressources et les parties planifiées dans une vue.
L’outil de planification des séances
La version 2 génère des modèles d’horaires et utilise des listes déroulantes pour placer les parties. Elle n’a ni cet éditeur, ni le catalogue canonique complet, ni les verrous de partie ou l’optimisation locale autour des changements manuels.
L’éditeur de la version 3 permet de :
- Déplacer les parties entre l’horaire et la file par glisser-déposer.
- Modifier les heures, ajouter des séances en plaçant des parties, ou supprimer une séance et remettre ses parties dans la file.
- Verrouiller une partie pour que Répartir et Optimiser la laissent en place.
- Répartir les parties de tournoi à la ronde, les parties ponctuelles et les parties de tableau selon leurs règles d’ordre distinctes, en incluant les parties en attente sur demande.
- Remplir les pistes inutilisées avec des parties de la prochaine ronde logique lorsque des séances compactes comptent davantage qu’une nouvelle rangée par ronde.
- Voir précisément les parties à l’origine des valeurs Maximum de répétitions sur une piste, Total des répétitions et Répétitions consécutives.
- Ajouter une partie ponctuelle à un tournoi à la ronde précis pour qu’elle fasse partie de ses classements et pointages.
- Importer des affectations CSV pour des parties existantes sans recréer la structure de compétition.
- Enregistrer l’arrangement actuel comme modèle d’horaire du club ou appliquer volontairement un modèle correspondant.
- Partir d’un horaire canonique validé, puis optimiser les changements propres à l’événement sans déplacer les parties verrouillées.
Ces règles sont propres au curling. Le répartiteur distingue les parties de tournoi à la ronde, ponctuelles et de tableau. Il comprend les rondes logiques qui peuvent s’étendre sur plusieurs séances, tient compte des ressources sélectionnées et des placements fixes, et mesure les retours des équipes sur une même piste, y compris les séances consécutives. Il place les parties ponctuelles après les parties de tournoi à la ronde des équipes concernées, puis les parties de tableau déverrouillées après les parties de tournoi à la ronde et ponctuelles. Une partie verrouillée échappe à ces règles de placement.
Lorsqu’un événement contient un tournoi à la ronde complet et aucun verrou incompatible, Répartir vérifie notre catalogue avant toute recherche dans le navigateur. Plusieurs itérations répètent la disposition correspondante du catalogue comme point de départ. Un modèle du club correspondant est présenté séparément et appliqué seulement si le responsable de l’horaire le choisit. Lorsque des verrous, parties ponctuelles, étapes multiples ou placements manuels changent le problème, l’optimiseur du navigateur travaille à partir de l’horaire réel.
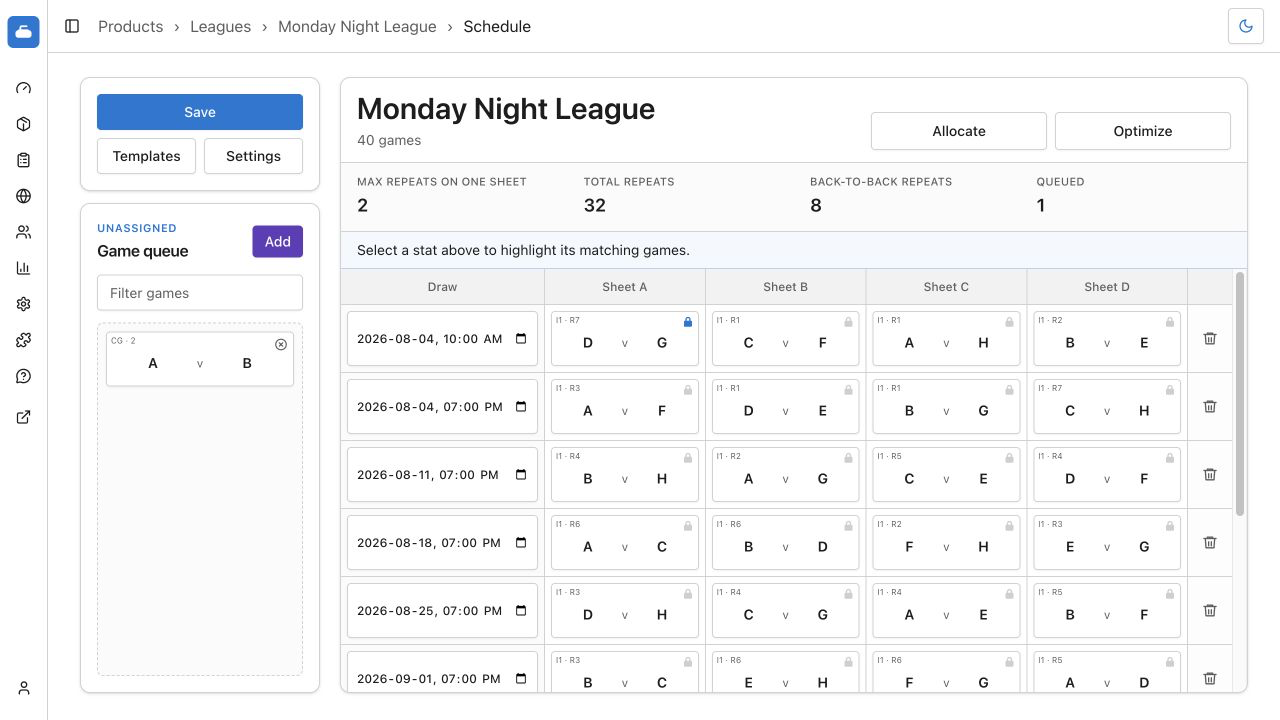
Le verrou bleu indique un placement que la répartition automatique doit conserver. La file contient une deuxième rencontre ponctuelle entre A et B, prête à placer.
Voir le parcours de planification des séances
Ce tutoriel montre comment configurer, répartir, modifier, inspecter, optimiser, enregistrer et réutiliser un horaire de séances d’événement.
Pour les responsables d’horaires : comment nous avons construit le catalogue
La suite devient technique. Elle explique la notation des horaires, les algorithmes testés, les solveurs exacts et la distinction entre les meilleurs horaires trouvés et les optimums prouvés. Vous êtes prévenus!
Le système de la version 3 a deux parties de calcul. Une application Rust hors ligne cherche et valide des horaires de base et prouve parfois leur optimalité. Un optimiseur JavaScript traite les changements propres à l’événement dans le navigateur : parties verrouillées ou ponctuelles et étapes de compétition partageant les mêmes ressources.
Le travail hors ligne a produit un catalogue versionné couvrant les 736 combinaisons de 2 à 24 équipes et de 1 à 16 pistes, selon les deux modes pris en charge de regroupement dans les séances. Curling IO v3 charge directement ce catalogue pour répartir un horaire d’événement.
Le catalogue contient actuellement 449 dispositions : 419 prouvées optimales et 30 meilleurs résultats trouvés jusqu’ici. Cela comprend 448 exigences distinctes dans l’enveloppe pratique et un cas historique hors norme conservé pour compatibilité.
Objectif de planification
Nous évaluons l’équité des pistes comme un tuple ordonné :
- Maximum de retours : le plus grand nombre de visites supplémentaires d’une équipe sur une piste.
- Total des retours : chaque visite de chaque équipe après sa première sur une piste.
- Retours consécutifs : les cas où une équipe joue sur la même piste dans des séances voisines.
Plus bas est meilleur. Nous comparons le premier nombre, puis le deuxième, puis le troisième. Le temps d’exécution ne compense jamais un horaire moins bon.
Pour huit équipes et quatre pistes, (1, 24, 0) signifie qu’aucune équipe ne visite une piste plus de deux fois, qu’il y a 24 retours au total et qu’aucune ne revient sur la même piste dans des séances consécutives.
Ces 24 retours sont inévitables. Huit équipes font 56 visites équipe-piste en sept séances, pour seulement 32 combinaisons uniques. Même un horaire parfaitement équilibré a au moins 56 - 32 = 24 retours. Atteindre cette borne inférieure avec au plus une visite supplémentaire et aucun retour consécutif prouve qu’il n’y a rien à améliorer selon nos règles de notation.
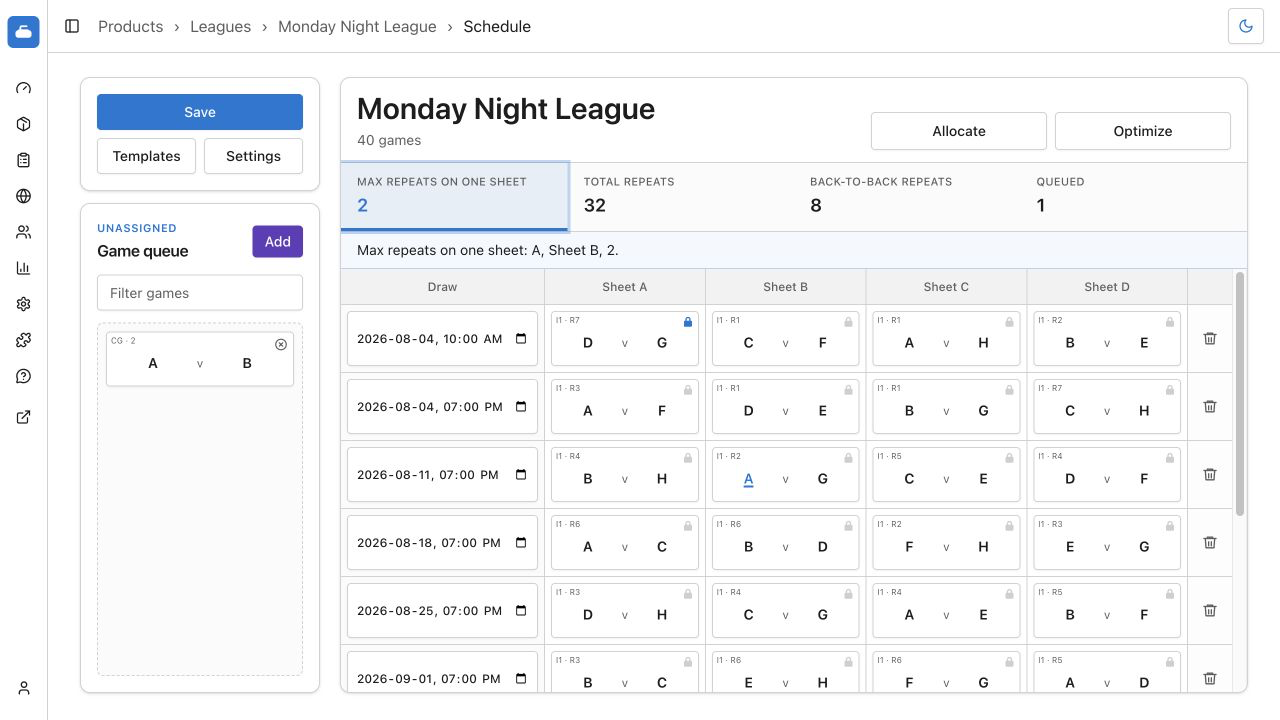
Les statistiques sont inspectables dans l’éditeur. En sélectionner une met en évidence les parties et équipes qui l’ont produite.
Nous avons choisi un tuple ordonné plutôt qu’une note pondérée, car les poids cachent les compromis. Éviter la sixième visite d’une équipe sur la piste A vaut-il trois nouveaux retours consécutifs ailleurs? Une note scalaire ne répond qu’après l’invention d’un taux de conversion. Le tuple rend les priorités explicites.
L’IA est-elle bonne pour générer des horaires de séances?
Nous avons testé si les modèles IA généralistes actuels pouvaient produire ces horaires à partir d’une demande normale de responsable d’horaire. Le test portait sur un appel direct unique au modèle, pas sur un agent ayant accès à notre validateur ou à une boucle de correction.
La formulation a demandé du travail. Les premières demandes, pourtant tout à fait naturelles, retournaient souvent des affrontements manquants ou en double, surtout avec un nombre impair d’équipes. Nous les avons affinées pour approcher les précisions qu’un responsable donnerait dans une courte conversation. La version finale indiquait le nombre de parties attendu, demandait un seul tableau Markdown et demandait au modèle de vérifier son travail. Elle ne fournissait ni liste des affrontements, ni nombre minimal de séances, ni tuple d’équité, horaire en cache, méthode du cercle ou autre algorithme.
Lire la traduction de la demande exacte pour 8 équipes et 4 pistes
Crée un horaire de séances de curling pour un tournoi à la ronde simple avec 8 équipes et 4 pistes. Nomme les équipes de 1 à 8 et les pistes de A à D.
L’horaire doit contenir exactement 28 parties, une par paire d’équipes unique. Une équipe ne peut pas jouer plus d’une fois dans une séance.
Essaie de répartir les parties de chaque équipe entre les pistes, surtout en évitant la même piste dans des séances consécutives. Des affrontements corrects comptent plus qu’un équilibre parfait des pistes.
Avant de répondre, compte les parties et vérifie les affrontements manquants ou en double. Retourne un seul tableau Markdown complet, pas un tableau par séance. Utilise une rangée par séance et des colonnes nommées Draw, Sheet A à Sheet D. Écris chaque partie comme 1 vs 2, laisse les cellules de pistes inutilisées vides et ajoute une colonne Bye au besoin.
Seuls le nombre d’équipes, le nombre de pistes, les libellés et le nombre attendu de parties changeaient pour les autres cas de test.
Nous avons envoyé cette demande figée à OpenAI et Anthropic par leurs API directes. Nous avons ajouté Gemini dans un passage distinct par OpenRouter, fixé sur Google AI Studio sans repli de fournisseur. Chaque modèle a reçu une fois les mêmes cinq cas : 8 équipes sur 4 pistes, 8 sur 2, 9 sur 4, 11 sur 5 et 14 sur 7. Chaque requête partait d’un contexte neuf d’un seul message, utilisait le raisonnement par défaut du fournisseur et avait une limite stricte de cinq minutes. Nous avons conservé toutes les réponses, y compris les dépassements de délai.
La disposition familière à 8 équipes et 4 pistes est publiée depuis des années et pourrait apparaître dans les données d’entraînement. Nous l’avons gardée comme cas d’étalonnage, pas comme preuve que le modèle avait trouvé la réponse lui-même. Nous avons aussi exclu de ce tableau les essais informels dans les applications de clavardage grand public, qui peuvent ajouter des instructions cachées, du routage de modèles et des réglages de raisonnement.
Les résultats ont été analysés et vérifiés indépendamment. Le formatage sans conséquence pouvait être normalisé, mais l’évaluateur ne pouvait pas ajouter ou retirer une partie, changer un affrontement ou améliorer une affectation de piste. Un horaire devait contenir chaque affrontement exactement une fois, limiter chaque équipe à une partie par séance et passer le même calcul d’équité que Drawmaster. Les horaires non valides ne recevaient aucune note d’équité.
| API et modèle | Résultats valides | Temps de réponse médian | Jetons de sortie | Coût calculé |
|---|---|---|---|---|
OpenAI gpt-5.6-sol | 5/5 | 50,7 secondes | 21 079 | 0,64 $ |
Anthropic claude-opus-5 | 5/5 | 108,3 secondes | 59 070 | 1,48 $ |
Gemini google/gemini-3-flash-preview | 2/5 | 3,7 secondes | 3 338 | 0,01 $ |
Les jetons de raisonnement sont inclus dans les totaux de sortie, sans être comptés une deuxième fois. Un passage sur cinq cas constitue une base utile, mais pas un classement statistiquement robuste des modèles.
OpenAI et Claude ont retourné un horaire valide au nombre minimal de séances pour chaque cas. OpenAI a égalé ou dépassé Claude dans les cinq cas. L’équité des pistes donne toutefois un autre résultat :
Gemini a terminé chaque demande en 5,1 secondes ou moins, mais trois de ses cinq horaires étaient non valides. Les réponses 8×4 et 14×7 répétaient des affrontements malgré leur affirmation que chaque paire avait été vérifiée. La réponse 9×4 répétait deux affrontements et plaçait une équipe deux fois dans sa dernière séance. Ses deux horaires valides utilisaient le nombre minimal de séances, mais aucun n’égalait l’équité du catalogue.
| Cas | Catalogue actuel | Meilleur résultat IA | Comparaison |
|---|---|---|---|
| 8 équipes, 4 pistes | (1, 24, 0) | (2, 24, 0) | Curling IO est meilleur |
| 8 équipes, 2 pistes | (3, 40, 0) | (3, 40, 0) | Égalité, optimum prouvé |
| 9 équipes, 4 pistes | (1, 36, 0) | (2, 36, 0) | Curling IO est meilleur |
| 11 équipes, 5 pistes | (1, 55, 0) | (2, 55, 0) | Curling IO est meilleur |
| 14 équipes, 7 pistes | (1, 84, 0) | (2, 84, 0) | Curling IO est meilleur |
Notre recherche Rust simple à départ neutre a égalé le meilleur résultat d’OpenAI dans les cinq cas, avec quelques secondes de travail local combiné par cas. Le processus hors ligne beaucoup plus lourd a ensuite produit le catalogue actuel, meilleur dans quatre cas et égal dans le cinquième.
L’IA reste utile comme générateur supplémentaire de candidats hors ligne. Elle peut trouver un horaire manqué par nos méthodes. Nous traitons simplement sa réponse comme tout candidat non fiable : l’analyser, valider chaque affrontement et conflit, calculer la note nous-mêmes et prouver l’optimalité lorsque possible. Pour les horaires personnalisés, l’optimiseur du navigateur travaille autour des verrous et parties supplémentaires dans une limite de 100 ms, plutôt que de demander à un modèle généraliste de reconstruire l’horaire à partir de texte.
Enveloppe de recherche
Notre enveloppe pratique comprend :
- De 2 à 24 équipes.
- De 1 à 16 pistes sélectionnées.
- Un tournoi à la ronde complet.
- Une itération.
- Aucune partie verrouillée, ponctuelle ou de tableau.
- Deux comportements lorsqu’une ronde logique s’étend sur plusieurs séances : commencer chaque ronde dans une nouvelle séance ou remplir les pistes vides avec des parties de la ronde suivante.
Cela donne 23 × 16 × 2 = 736 clés de recherche.
Les deux réglages de regroupement ne produisent pas toujours des dispositions différentes. Si toutes les parties d’une ronde tiennent dans une séance, aucune piste vide ne peut accueillir la ronde suivante. Regrouper ces cas équivalents réduit l’enveloppe à 448 exigences de disposition distinctes. Le catalogue stocke 449 dispositions parce qu’il conserve aussi une forme historique hors enveloppe : 26 équipes sur 7 pistes.
Cette frontière n’était pas arbitraire. Nous avons analysé les données Curling IO. Parmi des milliers d’horaires générés d’une seule itération avec peu de pistes, 98 % avaient au plus 20 équipes et 8 pistes. Les cinq formes les plus courantes étaient 8×4, 12×6, 6×3, 10×5 et 9×4, soit 63 % de cette cohorte.
Nous avons étendu la couverture à 16 pistes, car les dispositions avec des pistes excédentaires sont peu coûteuses à stocker et utiles à prendre en charge. Nous avons ensuite porté la limite d’équipes à 24. Les cas historiques hors norme de 42 équipes ne justifiaient toujours pas d’étendre autant la cible interactive.
Banc de recherche
L’implémentation CurlingSchedules d’origine avait déjà un générateur circulaire de tournoi à la ronde, un répartiteur glouton de pistes, des ajustements locaux et un petit cache de correspondances exactes. Nous avions aussi beaucoup expérimenté, notamment avec une branche de recuit simulé.
Le premier problème était la mesure. Des essais historiques utilisaient des poids différents, d’autres une ancienne définition du maximum de répétitions, et certains tests ne vérifiaient pas ce qu’annonçait leur nom. Les résultats de fonctions objectifs différentes n’étaient pas directement comparables.
Nous avons créé une application Rust comme banc de recherche avec :
- Un modèle d’horaire de référence et un validateur indépendant.
- Des cas de test et des graines déterministes.
- Des stratégies de recherche interchangeables.
- Des comparaisons appariées à budgets égaux.
- Des rapports texte, JSON et CSV.
- Une pondération selon les fréquences de production des données Curling IO.
- Des points de contrôle atomiques permettant de reprendre les longues recherches.
- Un catalogue versionné où chaque disposition porte sa méthode, sa graine, son effort, son temps d’exécution, sa borne inférieure et son statut de preuve.

Les horaires générés passent par la recherche heuristique, les méthodes exactes et un validateur indépendant avant d’entrer au catalogue versionné.
Les dispositions en cache servaient de cibles de comparaison, jamais d’entrées de recherche. Chaque algorithme devait produire son résultat à partir des mêmes conditions initiales générées.
Rust convenait bien à ce travail pour plusieurs des raisons de notre choix du langage côté serveur de Curling IO v3. L’exécution native permettait d’évaluer beaucoup de candidats. Le système de types rendait difficile le mélange d’un horaire partiel non valide avec un résultat censé être valide. Le même banc pouvait effectuer des comparaisons limitées ou reprendre de longues recherches exactes. C’était un petit projet de recherche appelé à changer constamment, mais l’exactitude comptait toujours.
Algorithmes évalués
Aucun algorithme ne gagnait sur tous les cas. Le processus hors ligne final combine des méthodes aux coûts et forces différents.
| Approche | Forces | Leçons |
|---|---|---|
| Génération gloutonne | Produire rapidement une base déterministe valide | Les choix locaux de piste manquent de recul; multiplier les reconstructions aléatoires ne garantit pas un meilleur bassin |
| Échanges simples, doubles, triples et quadruples | Améliorations locales peu coûteuses | Deux ou trois déplacements peuvent sortir de certains optimums locaux, mais plus profond n’est pas automatiquement meilleur |
| Déplacements ciblés | Consacrer l’effort aux équipes et pistes qui bloquent la prochaine amélioration de l’équité | Réutiliser les registres de notation améliorait la qualité et la rapidité |
| Recherche taboue et parcours de plateaux | Passer par des états de même note | Une recherche limitée aux améliorations strictes se bloque trop tôt |
| Reconstruction gloutonne | Entrer dans une autre région de l’espace de recherche | Des redémarrages indépendants étaient plus utiles que le polissage répété d’un horaire |
| Groupes d’élite et populations | Conserver plusieurs candidats forts et différents | Plus de diversité ne produit pas automatiquement de meilleurs horaires |
| Recuit simulé | Améliorer occasionnellement un cas non résolu | Ce n’était pas une stratégie générale compétitive dans nos budgets mesurés |
| Destruction-reconstruction, croisement, rotations et déplacements de colonnes de pistes | Ajouter des voisinages précis à un portefeuille | La plupart dépendaient du cas, et plusieurs servaient seulement de témoins négatifs |
| Résolution de contraintes et séparation-évaluation | Prouver une cible atteignable ou impossible | Les méthodes exactes fonctionnent mieux après une bonne décomposition du problème |
| Constructions combinatoires | Résoudre directement des familles complètes | La bonne réponse est parfois une construction, pas davantage de recherche |
Recherche locale
L’optimiseur le plus simple essaie un échange légal de parties et le conserve seulement si le tuple s’améliore. Notre version de profondeur deux essaie un deuxième échange même si le premier est très mauvais. Elle garde les deux seulement si le résultat combiné bat l’horaire intact. Sur 20 départs neutres à huit équipes, la profondeur deux a battu la recherche à un échange 16 fois et atteint deux fois l’optimum connu.
La profondeur trois a encore amélioré les chances sans dominer la profondeur deux. Sur 1 000 départs appariés, elle a gagné 394 fois, fait égalité 310 fois et perdu 296 fois. La profondeur quatre a ensuite perdu plus souvent qu’elle n’a gagné contre la profondeur trois. De plus grands voisinages ouvraient des chemins, mais dépensaient aussi davantage du budget fixe à en explorer d’inutiles.
Le ciblage aidait plus régulièrement. Nous choisissions surtout les parties sources parmi les affectations équipe-piste qui bloquaient la prochaine réduction du maximum de répétitions. Nous avons ensuite ajouté une mémoire taboue pour parcourir des états d’équité égale encore inexplorés plutôt que de rebondir entre les mêmes arrangements.
Le cas classique 8×4 a tout de même montré la limite des déplacements locaux. Une vérification exacte a prouvé qu’un regroupement précis d’affrontements ne pouvait pas faire mieux que (1,24,5). L’optimum global était (1,24,0). Aucune permutation de pistes dans ce regroupement ne pouvait combler l’écart : il fallait regrouper les affrontements autrement entre les séances.
C’est une limite de la recherche locale. Certaines améliorations exigent de changer les parties qui partagent une séance, au-delà de leurs pistes.
Recuit simulé
Nous avons essayé le recuit simulé deux fois : dans l’ancienne implémentation Gleam, puis dans une expérience Rust volontairement plus petite. La grande version historique avait des courbes de température, du réchauffement, des redémarrages, des poids de déplacement adaptatifs, des cycles de pistes, des rotations de séances, des déplacements ciblés et plusieurs phases. Elle conservait le meilleur candidat. Retourner un état chaud dégradé n’expliquait donc pas sa performance.
Compte tenu de l’effort consacré à comprendre et à implémenter le recuit simulé, les résultats étaient décevants. La petite version Rust rendait la comparaison plus fiable. Elle restait compétitive sur 8×4, mais perdait sur l’ensemble plus large des cas. Le recuit apportait de la diversité au portefeuille pour une forme, sans preuve suffisante pour en faire une stratégie générale.
Nous avons conservé ce résultat négatif dans le dossier de recherche. Affiner davantage les températures était moins prioritaire que les approches améliorant plus de cas avec le même budget d’évaluation.
Reconstruction et portefeuilles
La reconstruction gloutonne conserve les séances et les règles de compétition, mais refait les affectations de pistes à partir d’un nouvel ordre déterminé par une graine. Cinq départs reconstruits indépendants ont battu cinq départs ordinaires avec le même budget total d’évaluation. Cela ne résolvait pas tous les cas, mais atteignait des bassins invisibles à la recherche par échanges seuls.
Notre portefeuille hors ligne a fini par conserver des processus de reconstruction et de population indépendants, avec une voie distincte qui exploitait le meilleur candidat validé trouvé jusqu’ici. Forcer tous les processus à repartir du meilleur résultat global réduisait la diversité sans aider. Le partage devenait utile seulement comme travail supplémentaire, sans remplacer la recherche privée de chaque processus.
Nous avons donc ajouté des points de contrôle pour l’état privé de chaque processus et le meilleur résultat global. Une longue recherche peut s’arrêter et reprendre en conservant les deux.
Méthodes exactes et constructions
La recherche heuristique fournissait de bons candidats, mais prouver l’optimalité exigeait des méthodes exactes.
Nous les avons ajoutées par couches plutôt que de donner tout le problème à un seul solveur :
- Affectation de pistes à séances fixes : garde les affrontements et la composition des séances, puis résout seulement la piste de chaque partie.
- Modèles de rondes logiques : peuvent répartir de nouveau les parties entre les séances d’une ronde en conservant ses frontières.
- Recherche de factorisation compacte : choisit le regroupement d’affrontements et les pistes pour les petits horaires à séances pleines.
- Requêtes de réparation bornées : demandent si une cible connue est atteignable dans un rayon donné d’une bonne solution courante.
- Constructions combinatoires : génèrent directement des familles de plans connues, comme les plans de tournois équilibrés partitionnés.
Le solveur de contraintes à séances fixes a amené plusieurs formes courantes à leur borne inférieure globale. Un passage exact ultérieur a prouvé l’optimalité de 64 des 74 dispositions à beaucoup de pistes encore non résolues, environ 86 %. La séparation-évaluation compacte a aussi prouvé la borne inférieure 10×5 à partir d’entrées générées, sans lire l’horaire en cache, et traité de petits horaires à nombre impair d’équipes avec des couplages presque parfaits.
Les résultats exacts ont aussi montré les limites de la formulation de recherche. Un tournoi à la ronde 16×8 est un plan de tournoi équilibré partitionné de côté huit. Une construction publiée de type starter-adder a produit directement la borne globale (1,112,0). La recherche locale stagnait parce qu’un bon horaire heuristique exigeait de changer au moins 41 placements partie-piste dans sa composition de séances existante.
Pour 19 équipes sur 9 pistes, la réparation bornée ne pouvait pas atteindre (1,171,17) en changeant au plus 10 cellules. Nous avons retiré les variables redondantes et encodé directement la condition de borne inférieure : chaque équipe utilise chaque piste exactement deux fois. Z3 a trouvé (1,171,0) sur la structure cyclique d’affrontements existante. La solution différait des pistes de départ dans 151 des 171 cellules de parties, environ 88 %. Le rayon de réparation locale excluait les solutions pertinentes.
Nous avons ensuite exécuté une finition exacte sur l’ordre des rondes. Chaque ronde logique complète devient un bloc. La méthode cherche le meilleur chemin entre ces blocs sans changer les affrontements, les pistes ou les parties réunies dans une séance. Cela a amélioré 28 entrées du catalogue et prouvé l’optimalité de 23. Le passage refuse délibérément les horaires compacts dont les séances traversent les frontières de rondes plutôt que de deviner les regroupements.
Un court balayage de contraintes a produit 51 preuves supplémentaires. Quarante-neuf ont terminé en moins d’une seconde sur la machine de développement. Le plus grand écart de retours consécutifs restant concernait 17 équipes sur 8 pistes : il est passé de (1,136,16) à la borne globale (1,136,0) en environ 25 secondes. Les deux modes de regroupement à 13 équipes et 4 pistes restaient non résolus après une tentative d’une minute.
Enfin, nous avons généralisé l’énumérateur de rondes complètes pour permettre des pistes excédentaires. Il a épuisé six petits espaces de recherche, prouvé les six optimums et amélioré l’entrée à 6 équipes et 5 pistes de (1,3,0) à (1,2,0). Ces preuves comptent, car la borne inférieure générique peu coûteuse n’est pas atteignable pour toutes les formes.
Dix-sept dispositions étaient encore marquées comme meilleurs résultats trouvés. La parité des degrés du graphe et une borne de transition sur une seule piste en ont prouvé 12 sans changer les horaires. Des constructions cycliques par différences d’arêtes ont ensuite résolu les formes à 9 et 13 équipes sur deux pistes. Des recherches complètes de coloration d’arêtes, d’appariement de séances et d’ordre des séances ont résolu celles de 6 et 7 équipes sur deux pistes.
Le dernier cas était 9 équipes sur 8 pistes. Les horaires complets avaient trop de symétries. Nous avons donc séparé le problème en plus petits problèmes exacts. Un modèle pseudo-booléen a d’abord affecté les 36 parties aux pistes. Une factorisation exacte a ensuite formé neuf séances légales, puis une recherche de chemin hamiltonien les a ordonnées sans retours consécutifs. Le résultat est passé de (1,5,0) à la borne globale (1,4,0).
Nous avons ensuite étendu le catalogue à 24 équipes. Des plans publiés de tournois équilibrés partitionnés ont fourni des horaires exacts à 22 équipes et 11 pistes, puis à 24 équipes et 12 pistes. Séparer leurs deux moitiés équilibrées a aussi prouvé neuf formes à pistes excédentaires. L’ordre exact des séances et la construction existante de séparation pour les nombres impairs ont prouvé 14 autres dispositions. Les nouvelles formes restantes reçoivent toujours un horaire validé en cache, mais gardent Optimiser disponible pendant leur étude hors ligne.
Couverture et statut de preuve
La révision 23 du catalogue résout toutes les formes d’équipes et de pistes dans l’enveloppe pratique de 2 à 24 équipes et de 1 à 16 pistes. Sur les 449 dispositions stockées, 419 sont prouvées optimales et 30 gardent des meilleurs résultats trouvés validés.
Parmi les 419 dispositions prouvées, 392 atteignent la borne inférieure globale générique. Les 27 autres exigent une preuve plus précise : 16 utilisent une borne de parité des degrés du graphe, une utilise une borne de transition sur une piste et dix utilisent une recherche exhaustive. La forme impaire à cinq équipes et deux pistes en est un exemple. L’énumération exacte a prouvé que quatre retours consécutifs ne pouvaient pas être éliminés. De petites formes à pistes excédentaires donnent d’autres exemples, car des parties partageant une séance doivent encore avoir des pistes distinctes.
Chaque recherche dans l’enveloppe définie a un résultat validé en cache. Les 30 meilleurs résultats trouvés restent dans la file d’amélioration. Les dispositions prouvées restent dans la suite de régression, mais ne reçoivent plus de budget de recherche hors ligne tant que l’enveloppe ou les règles de notation ne changent pas.
Rust hors ligne et JavaScript dans le navigateur
Précalculer les dispositions ordinaires change le rôle de l’optimiseur du navigateur. Il sert aux horaires qui ne correspondent plus aux entrées canoniques.
Un événement réel peut avoir :
- Plusieurs groupes de tournoi à la ronde qui partagent des pistes.
- Plusieurs itérations, où combiner des dispositions canoniques crée de nouveaux motifs de répétition.
- Des parties verrouillées que Répartir et Optimiser ne doivent pas déplacer.
- Des parties ponctuelles pour compléter des tournois à la ronde déséquilibrés.
- Des parties de tableau qui doivent suivre leurs prédécesseurs.
Ces combinaisons sont trop propres aux événements pour un cache global. Elles ont toujours besoin d’une optimisation immédiate et réversible dans l’éditeur.
L’optimiseur du navigateur fonctionne dans un Web Worker annulable avec une limite stricte actuelle de 100 ms. Il conserve toujours l’entrée et le meilleur résultat valide trouvé. Un temps plus long peut donc ne rien améliorer, mais ne peut pas retourner un horaire moins bon.
Son répartiteur actuel utilise trois grandes politiques :
- Ordinaire : un horaire déverrouillé qui demande une amélioration locale générale.
- Réparation sous contraintes : des verrous ou placements fixes rendent la stabilité importante.
- Compatible avec les tableaux : l’ordre des parties et les frontières fixes des séances comptent davantage qu’une reconstruction plus large.
Il consacre 70 % du délai à la recherche de profondeur deux, puis le reste à la voie de réparation choisie. La voie compatible avec les tableaux garde la profondeur deux pendant tout le délai. Sur 700 cas de banc d’essai appariés, ce répartiteur à trois politiques a battu l’ancien sélecteur à cinq voies 22 fois, fait égalité 666 fois et perdu 12 fois.
Ce résultat apparié appuyait le répartiteur plus simple. Il retourne presque toujours une réponse égale ou meilleure, travaille hors du fil principal et choisit sa politique à partir des caractéristiques visibles de l’horaire.
Les implémentations navigateur et Rust partagent le vocabulaire, les attentes du validateur, le tuple d’équité, les cas de test et les preuves. Le budget Rust hors ligne est pratiquement sans contrainte : populations, solveurs exacts, processus parallèles et points de contrôle de longues recherches sont possibles. Celui du navigateur est strict, car une optimisation plus longue nuirait visiblement à la réactivité de l’éditeur.
Distribution du catalogue et sélection à l’exécution
Drawmaster écrit un catalogue JSON versionné. Chaque entrée contient les équipes, séances et pistes indexées, ainsi que le tuple d’équité, la borne inférieure, la méthode de production, le statut de preuve, la commande et les éléments de validation indépendante.
Notre paquet partagé de planification Curling possède le catalogue, intégré au créateur d’horaires d’événement de Curling IO v3. L’éditeur gratuit CurlingSchedules.com utilise le même artefact, mais son interface et sa persistance dans le stockage local restent distinctes de Curling IO. Une recherche 8×4 trouve le même horaire canonique aux deux endroits.
L’ordre à l’exécution est le suivant :
- Chercher une disposition canonique exacte.
- L’appliquer immédiatement lorsqu’elle correspond sans risque aux équipes et aux pistes choisies.
- Répéter ou composer des dispositions pour les itérations et les groupes multiples.
- Réparer autour des verrous, parties supplémentaires, parties de tableau et placements manuels.
- Générer directement seulement si aucun point de départ du catalogue n’est utilisable.
Une disposition exacte d’une seule itération marquée comme prouvée optimale désactive Optimiser. Le bouton n’a rien d’utile à faire. Le format du catalogue peut toujours contenir un meilleur résultat trouvé si l’enveloppe s’élargit avant la preuve de son optimum. Dans ce cas, Optimiser reste disponible. Les horaires répétés, composés ou réparés restent aussi optimisables, car la preuve d’une seule itération ne couvre plus le résultat combiné.
Les modèles du club restent distincts. Le responsable peut appliquer volontairement un arrangement local récurrent plutôt que le choix global par défaut. La version 3 avertit avant que ce modèle déplace des parties déjà placées. Les modèles expriment la préférence d’un club. Le catalogue canonique exprime le meilleur résultat général que nous pouvons valider pour une forme numérique.
Constats
La recherche a produit ces conclusions de travail :
- Une couverture complète validée primait sur davantage de recherche pour une disposition déjà bien comprise.
- Aucune heuristique ne dominait toutes les formes d’équipes et de pistes. Leur variance dépassait nos attentes.
- Une plus grande profondeur ne garantissait pas un meilleur résultat avec un budget fixe.
- Parcourir des plateaux de même note comptait, sans pouvoir réparer une mauvaise factorisation d’affrontements.
- La reconstruction et les portefeuilles indépendants trouvaient différents bassins plus sûrement qu’une longue marche locale.
- Le recuit simulé n’était pas assez performant pour devenir une stratégie générale.
- Les solveurs exacts devenaient pratiques après une bonne séparation du problème en couches.
- Les plans combinatoires publiés donnaient des solutions directes aux familles d’horaires applicables.
- Le statut de preuve doit accompagner chaque réponse en cache.
- Le meilleur optimiseur de production est souvent une recherche en cache suivie d’une petite réparation propre au domaine.
Le catalogue actuel couvre l’enveloppe cible de la version 3, et chaque disposition stockée est prouvée optimale. La recherche restante porte sur la réparation propre à l’événement autour des verrous, parties ponctuelles, parties de tableau et ressources partagées, ainsi que sur les futures extensions de l’enveloppe.
Curling IO v3 associe chaque disposition abstraite du catalogue aux vraies équipes, ressources, séances et parties de l’événement. Le responsable peut ensuite appliquer des modèles du club, importer des affectations, ajouter des parties ponctuelles et modifier manuellement l’horaire en préservant les placements qu’il choisit de verrouiller.
Glossaire
- Tuple d’équité : la note ordonnée
(Max, Total, Back-to-back)qui compare les horaires. Plus bas est meilleur, et les nombres sont comparés de gauche à droite. - Heuristique : méthode conçue pour trouver rapidement un bon horaire sans prouver qu’il est le meilleur possible.
- Recherche locale : amélioration d’un horaire par des changements voisins de son arrangement actuel.
- Profondeur d’échange : nombre de déplacements évalués ensemble avant de les conserver ou non. Une recherche de profondeur deux peut garder deux déplacements dont le résultat combiné améliore l’horaire initial.
- Plateau : groupe d’horaires différents avec la même note.
- Parcours de plateau : passage par des horaires de même note pour chercher une position permettant une amélioration.
- Recherche taboue : conservation d’une courte mémoire des déplacements ou horaires récents pour éviter de les répéter en boucle.
- Recuit simulé : recherche qui accepte parfois un déplacement moins bon pour sortir d’un optimum local, généralement avec une tolérance décroissante au fil du temps.
- Bassin : région de l’espace de recherche où les déplacements voisins tendent vers le même optimum local.
- Portefeuille : plusieurs stratégies ou processus de recherche indépendants, dont on conserve le meilleur résultat validé.
- Méthode exacte ou solveur : méthode capable d’établir si une cible est atteignable ou de prouver qu’aucun meilleur horaire valide n’existe.
- Séparation-évaluation : méthode exacte qui cesse d’explorer une branche lorsque sa borne mathématique prouve qu’elle ne peut pas battre le meilleur résultat connu.
- Borne inférieure : note qu’aucun horaire valide ne peut battre. Atteindre une borne applicable prouve l’optimalité.
- Prouvé optimal : horaire validé pour lequel aucun meilleur tuple d’équité ne peut exister.
- Meilleur résultat trouvé : meilleur horaire validé trouvé jusqu’ici, sans preuve qu’il n’en existe pas de meilleur.
- Point de contrôle : état de recherche enregistré qui permet de reprendre un long processus sans repartir de zéro.